회사 서비스 중에 IoT 기기로 측정한 산소포화도와 맥박수를 실시간으로 모니터링하고, 리포트 대시보드로 보여주는 앱이 있다. 측정 데이터는 AWS DynamoDB와 로컬 SQLite 양쪽에 나뉘어 저장되기 때문에 두 DB를 맞춰주는 작업이 필요하고, 그래서 로그인 직후에 서버에 쌓여 있던 데이터를 로컬로 내려받는 동기화 과정을 거친다.
IoT 기기에서 전달받는 데이터는 2.5초에 한 건씩 쌓인다. 동기화 시 최대 3개월 치를 가져올 수 있는데, 하루 15시간씩 측정한다고 잡으면 200만 건에 가까운 양을 한 번에 내려받는 상황이 생긴다. 실제로 테스트해보니 이 케이스에서 동기화에 22분이 걸렸다.
시간도 문제지만 더 급한 건 그 22분 동안 화면이 멈춰버린다는 점이었다. 로딩 스피너가 뚝뚝 끊기고, 오래 걸릴 걸 감안해서 넣어둔 "다운로드 건너뛰기" 버튼을 눌러도 아무 반응이 없다가 한참 뒤에야 확인 모달이 떴다. 22분이라는 시간을 줄이는 일은 별도 과제로 두기로 하고, 이 글에서는 멈춤 문제만 다룬다.
조회 및 저장 로직 파악
앱은 DynamoDB에서 조회한 데이터를 그대로 저장하지 않는다. 저장 전에 가공을 거치는데 이 로직이 꽤 무겁다. 과정만 추리면 이렇다.
0. DynamoDB에서 측정 데이터를 페이지 단위로 조회
1. 각 측정 데이터 패킷 base64 디코딩 → 복호화 → 원본 측정 문자열
2. 에러코드 검사 → 센서 에러, 미연결 등 유효하지 않은 데이터 제외
3. 저장용 포맷으로 변환 → 재암호화
4. 원본에서 유효 측정값을 계산해 리포트 데이터 도출 → 재암호화
5. 200건씩 배치로 모아 네이티브 브리지로 로컬 SQLite에 저장
한 건마다 복호화 한 번, 암호화 두 번이 들어간다. CryptoJS가 메인 스레드를 오래 붙잡고 있을 거라고 봤고, 그렇다면 이 연산을 통째로 다른 스레드로 옮기는 게 가장 확실한 해법으로 보였다.
시도 1 : Web Worker 도입
메인 스레드가 비면 렌더링이 정상적으로 돌 테니 UI 블로킹도 사라질 거라고 생각했다.
가장 큰 걸림돌은 가공 로직이 Pinia store에 의존한다는 점이었다. 워커에는 Vue와 Pinia 컨텍스트가 없어서, store에서 읽던 값을 파라미터로 주입받는 순수 함수로 먼저 떼어내야 했다. 게다가 가공기는 직전 값을 누적하는 상태를 가지고 있어서 여러 워커로 병렬화하면 결과가 틀어진다. 결국 단일 워커에 순차 처리로 묶었고, 병렬화로 얻을 수 있는 속도 이득은 포기했다.
// syncData.worker.ts (요지)
const ctx = self as unknown as Worker;
let crypto, transformer;

ctx.onmessage = (e) => {
  const msg = e.data;
  if (msg.type === 'init') {
    // store 대신 파라미터로 주입
    crypto = createSyncCrypto(msg.userId, msg.isOverAir2);
    transformer = createMeasuredDataTransformer({
      isOverAir2: msg.isOverAir2,
      intensiveMax: msg.intensiveMax,
    });
    ctx.postMessage({ type: 'ready' });
    return;
  }
  if (msg.type === 'process') {
    const { batchMeasured, batchReport } = processSyncItems(msg.items, { crypto, transformer });
    ctx.postMessage({ type: 'processed', reqId: msg.reqId, batchMeasured, batchReport });
  }
};
// 메인 스레드: 페이지의 아이템을 청크로 잘라 워커에 넘기고, 받은 결과를 앱에 저장
for (let start = 0; start < items.length; start += WORKER_CHUNK) {
const rawChunk = items.slice(start, start + WORKER_CHUNK).map((it) => ({
u: it.userId.S, t: it.timestamp.S, b: it.base64.S, s: it.scanName?.S,
}));
const { batchMeasured, batchReport } = await worker.process(rawChunk); // ← 워커 왕복
await webToApp('REQ_DB_MEAS_INS_BATCH', { uid, measured_encrypted: batchMeasured });
await webToApp('REQ_DB_REPT_INS_BATCH', { uid, summary: batchReport });
}
시도 1 결과 : 달라진 게 없었다.
테스트해보니 UI 블로킹이 조금도 나아지지 않았다. 워커가 아예 실행되지 않은 게 아닐까 싶어 로그부터 확인했는데 그건 아니었다. 그래서 메인 스레드가 멈춰 있던 시간과 단계별 소요 시간을 함께 기록해봤다.
## (워커 실험은 재현이 빠른 약 13일치의 28만 건 데이터로 돌렸다)
[SYNC-DIAG] 요약 workerActive=true items=280890 total=70589ms
  sdk=7717ms  process=58749ms  bridge=4091ms
  jank={ "ticks":101, "jank250":84, "maxGap":1423 }
이상한 건 process 구간이었다. process는 await worker.process()를 기다린 시간이다. 크립토를 워커가 가져갔다면 그 대기 동안 메인 스레드는 놀고 있어야 하고, 화면도 부드럽게 그려져야 한다. 그런데 하필 그 시간에 메인 스레드가 최대 1.4초씩 얼어 있었다. 연산은 분명히 넘긴 게 분명한데
메인 스레드를 붙잡고 있던 건 워커와 데이터를 주고받는 통로인 postMessage였다.
Web Worker는 메인 스레드와 메모리를 공유하지 않는다. 데이터를 주고받으려면 postMessage(data)로 보내고 상대는 onmessage로 받는데, 이때 넘어가는 건 참조가 아니라 복사본이다. 객체를 그대로 건넬 수 없으니 보내기 전에 직렬화하고 받는 쪽에서 역직렬화한다. (이 복사 과정을 structured clone이라고 부른다.)
문제는 이 복사가 각자의 스레드에서 일어난다는 점이다.
- 메인이 워커로 200건을 보낼 때 → 메인 스레드가 직렬화
- 워커가 결과(측정 데이터와 리포트 수백 개)를 돌려줄 때 → 메인 스레드의 onmessage에서 역직렬화
청크마다 수백 개 객체를 메인 스레드에서 복사하는 비용이 계속 쌓였다. 크립토를 밀어내고 비워둔 자리를 복사 작업이 그대로 채웠다..
찾아보니 복사 비용을 줄일 방법이 아예 없지는 않았다.
결과를 객체 배열 대신 ArrayBuffer로 담아 Transferable로 소유권만 넘기면 복사 자체를 건너뛸 수 있고, 청크를 키워 왕복 횟수를 줄이는 방법도 있다. 저장까지 워커 안에서 끝내 결과를 메인으로 돌려보내지 않는 방법이 가장 깔끔한데, 네이티브 브리지가 웹뷰의 메인 컨텍스트에만 있어서 이건 앱 쪽 수정 없이는 불가능했다.
당시 팀 상황에서는 앱 수정을 포함한 구조 변경을 가져갈 수 없었고, 워커는 그냥 제거하게 되었다.
관점 전환
메인 스레드를 비우는 방향이 막혔으니, 메인 스레드가 일하는 중간중간 렌더링이 끼어들 틈을 만들어주는 쪽으로 방향을 틀었다.
사실 이전에도 틈을 주긴 했었다.
## 200건 배치 저장 후 잠깐 틈을 줬던 기존 방식
await webToApp('REQ_DB_MEAS_INS_BATCH', { uid, measured_encrypted: batchMeasured });
await utility.sleep(0); // sleep = (ms) => new Promise((r) => setTimeout(r, ms))
이걸로 아예 안 움직이기는 UI에서 많이 버벅이면서 움직이는 UI 정도로는 나아졌지만 여전히 매끄럽지 않았다. setTimeout(0)은 콜백을 태스크 큐에 넣을 뿐이고, 그 사이에 브라우저가 실제로 페인트를 한다는 보장이 없기 때문이다. 타이머 콜백이 연달아 쌓이면 렌더링은 또 뒤로 밀리게 되었다.
시도 2 : requestAnimationFrame(rAF) 적용
requestAnimationFrame은 브라우저에게 "다음 화면을 그리기 직전에 이 콜백을 실행해달라"고 예약하는 API다. 원래 애니메이션을 프레임에 맞춰 그리라고 있는 건데, 이 성질이 딱 필요했다.
- setTimeout(0): 콜백을 태스크 큐에 넣을 뿐, 실제 페인트는 보장되지 않는다
- requestAnimationFrame: 콜백이 페인트 파이프라인에 물려 있어 다음 페인트 직전 실행이 보장된다
await nextFrame()으로 양보하면 화면이 실제로 한 번 그려질 시간을 확보할 수 있다. setTimeout(0)에서 양보가 렌더를 보장하지 못했다면, rAF에서는 양보 한 번이 최소 한 프레임의 렌더가 된다.
양보 기준도 함께 바꿨다. 기존처럼 "200건마다"가 아니라 "N ms 넘게 일했으면"으로, 건수 대신 작업 시간을 기준으로 삼았다. 건당 처리 시간은 데이터에 따라 들쭉날쭉하지만, 프레임 예산으로 끊으면 어떤 데이터가 와도 멈춰 있는 시간의 상한이 일정해진다.
const FRAME_BUDGET_MS = 24; // 이 시간 넘게 일하면 한 프레임 양보

const nextFrame = (): Promise<void> =>
  new Promise((resolve) => {
    let settled = false;
    const done = () => { if (settled) return; settled = true; resolve(); };
    if (typeof requestAnimationFrame === 'function') requestAnimationFrame(done);
    setTimeout(done, 100); // 백그라운드에서 rAF이 멈출 때의 폴백
  });
// 처리 루프 안에서
if (performance.now() - frameStart >= FRAME_BUDGET_MS) {
  await nextFrame();          // 한 프레임 그릴 시간 확보
  frameStart = performance.now();
}
하지만 rAF은 앱이 백그라운드로 내려가면 콜백을 호출하지 않았다. 그대로 두면 동기화가 영영 멈춰버릴 수 있어서 setTimeout 폴백을 함께 걸어 안전장치를 뒀다.
24ms 설정 이유
FRAME_BUDGET_MS는 작을수록 화면이 부드럽지만 양보가 잦아져 총 소요 시간이 늘고, 클수록 반대다. 24ms를 고른 근거는 두 가지다.
첫째, 사용자 입력이 밀리는 최대 시간이다. 24ms 일하고 한 프레임을 양보하면, 버튼을 누른 시점이 최악이어도 40ms 안에는 처리된다. 사람이 버튼 반응 지연을 인지하기 시작하는 건 대체로 100ms 부근이니 여유가 있을 것이라 생각했다.
둘째, 이 화면의 성격이다. 여기는 동기화 로딩 화면이라 60fps로 부드럽게 그릴 이유가 없다. 스피너가 끊기지 않고 돌고, 건너뛰기 버튼이 즉각 반응하기만 하면 된다. 프레임을 더 자주 내주면서 22분을 25분으로 늘리는 건 과한 엔지니어링이라고 생각했다.
결과
| Before | After |
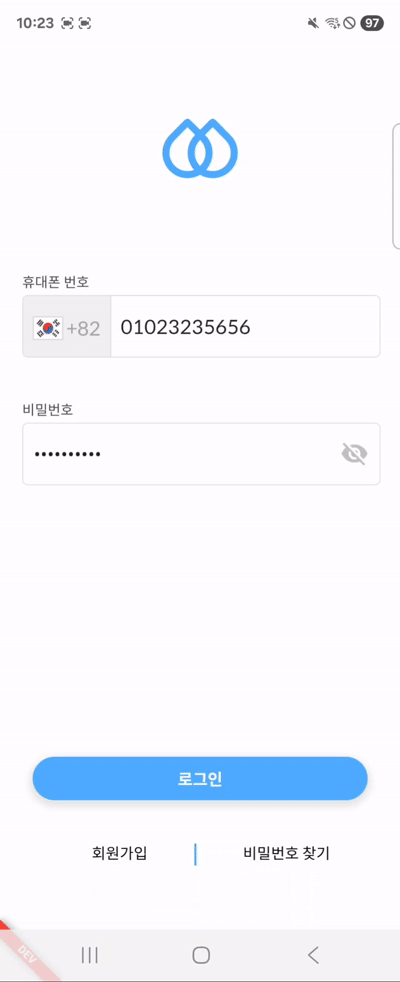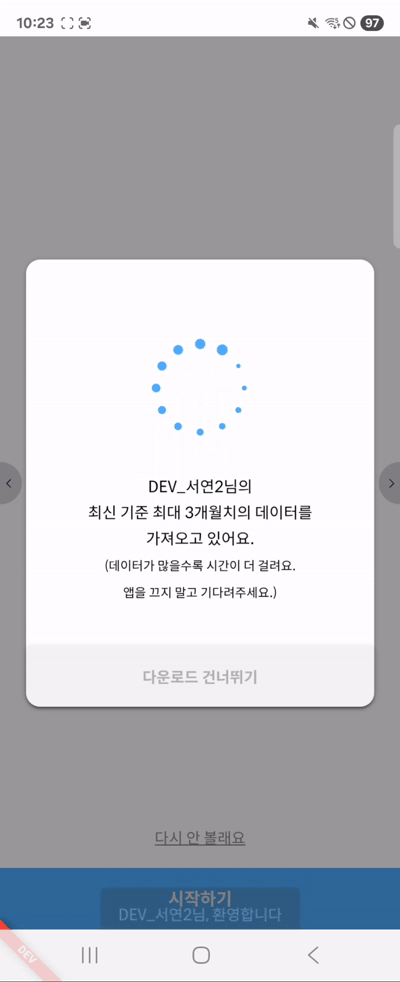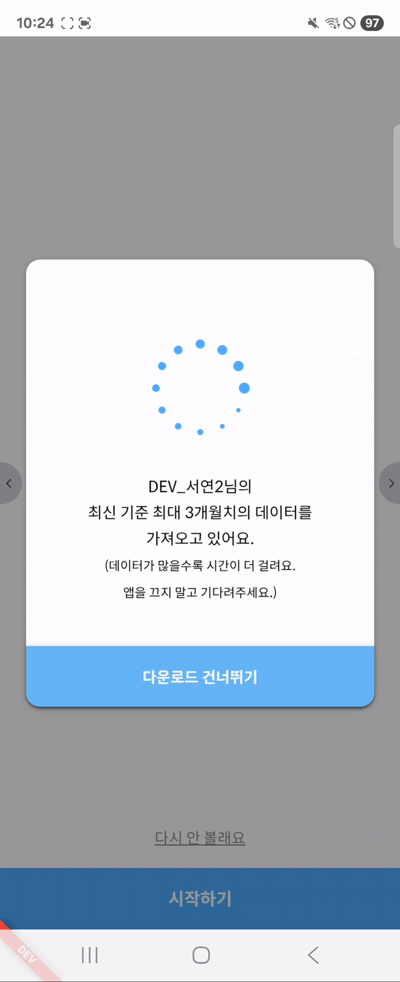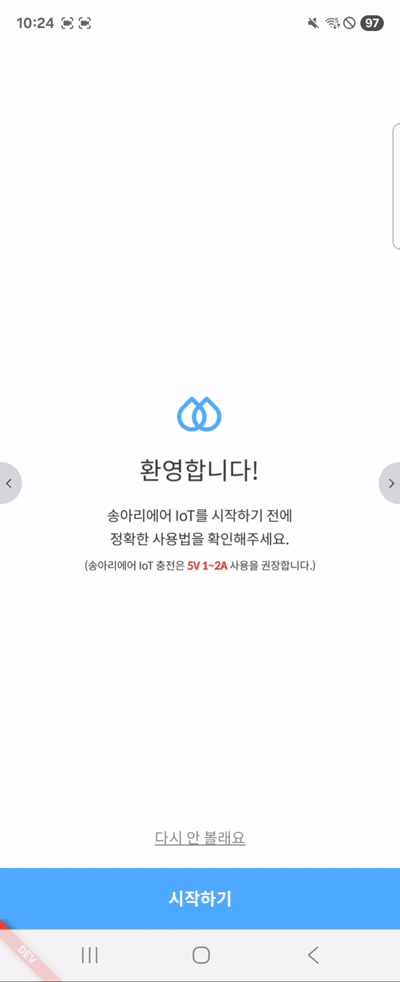 |
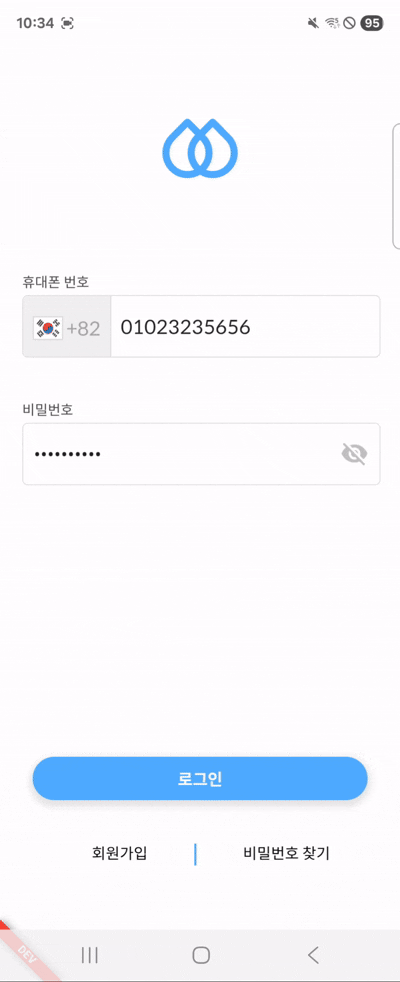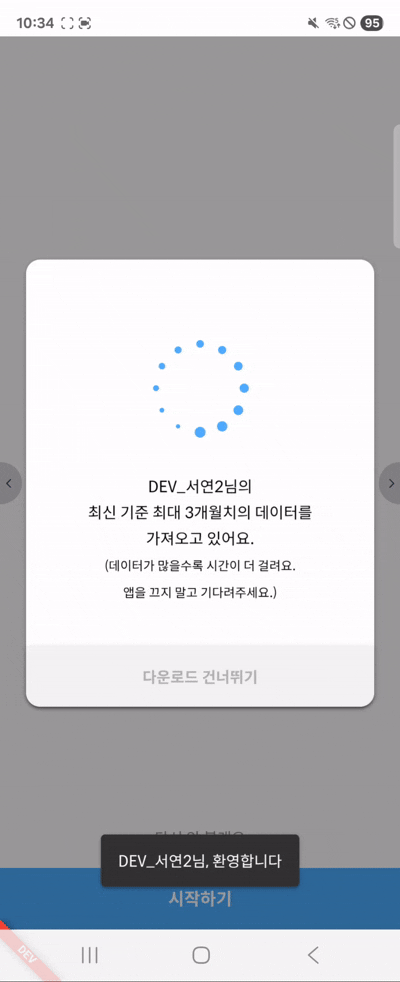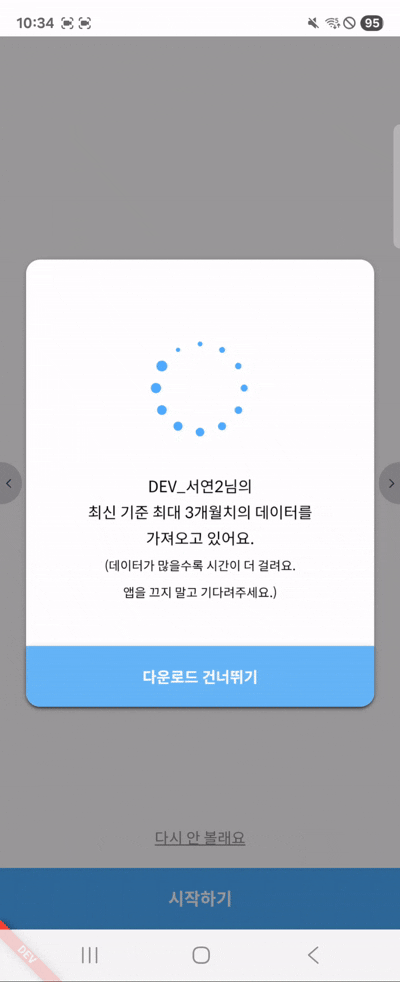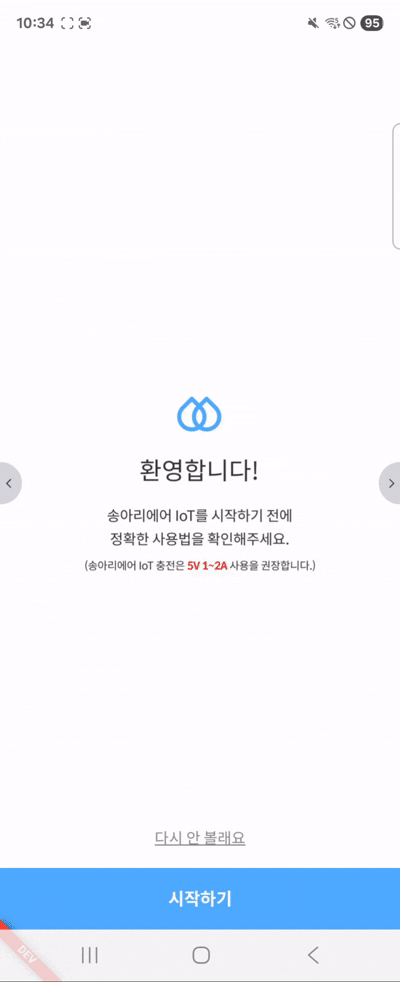 |
(개선 후 jank 로그는 까먹고 재측정하지 못했다..😭)
판단 기준은 스피너의 연속성과 건너뛰기 버튼의 응답 시간이었고, 위 영상이 그 기준으로 본 전후 차이다.
정리 및 아쉬움
지금의 해법은 멈춤을 자주 쉬어가게 만들어 감춘 것이고, 없앤 건 아니다. 근본 원인 하나가 그대로 남아 있다. 네이티브 브리지가 동기 호출이라 저장하는 순간마다 메인 스레드가 잠깐씩 멈춘다. 프레임 예산으로도 이 구간은 쪼갤 수 없다.
이걸 실제로 없애려면 네이티브 브리지를 비동기 배치 방식으로 바꿔야 할 것 같아 이건 앱 팀과의 다음 과제로 남겨뒀다.
'Tech' 카테고리의 다른 글
| 상용 환경에서야 잡은 하이드레이션 에러 ( i18n 번역파일 경로 이슈 ) (0) | 2026.01.19 |
|---|---|
| Promise를 외부로 꺼내 비동기 직접 제어하기 (Deferred Pattern) (0) | 2025.07.02 |
